Álvaro García Sánchez, Guillermo González-Santander de la Cruz y Antonio González Suárez, del equipo de Baobab, participan como autores en el nuevo Springer Handbook of Data Engineering con el capítulo «Predictive Analytics Models and Machine Learning». La obra reúne a profesores, investigadores y expertos internacionales para abordar los principales retos y aplicaciones de la ingeniería de datos.
Esta participación reconoce el conocimiento y la experiencia que el equipo desarrolla en analítica predictiva y machine learning, y refuerza la relación de Baobab con la comunidad académica. También refleja un principio de trabajo: el conocimiento que generamos en investigación es el mismo que incorporamos a nuestra plataforma.
La contribución al Springer Handbook of Data Engineering
por Guillermo González-Santander de la Cruz
Springer es una de las editoriales científicas y técnicas de referencia en el mundo. Sus Handbooks reúnen, en un único volumen, el conocimiento consolidado de una disciplina. Investigadores y profesionales los consultan cuando necesitan una base sólida sobre un tema. Escribir en una obra así es una forma de reconocimiento de Baboab en este ámbito de conocimiento, así como una muestra de nuestra voluntad de aportar a la difusión del conocimiento. Este tipo de publicaciones también implica una responsabilidad: el texto tiene que aguantar el paso del tiempo y ser útil para lectores con perfiles muy diversos.
Nuestra participación surge de la invitación del editor del volumen a propuesta de otros autores del libro. Con ellos habíamos colaborado en diferentes ocasiones, y confiaron en que sería valioso que Baobab compartiese el fruto de años de trabajo en analítica predictiva y aprendizaje automático, tanto en proyectos con clientes como en nuestras líneas de investigación.
La publicación llega en un momento especialmente relevante. La ingeniería de datos ocupa hoy un lugar central en las organizaciones que aspiran a tomar decisiones rigurosas y bien fundamentadas. A ello se suma un escenario en rápida transformación: la información disponible crece de forma constante, la oferta de herramientas y plataformas es cada vez más amplia y la inteligencia artificial evoluciona a un ritmo sin precedentes. En este contexto, un manual de referencia resulta especialmente valioso, ya que permite ordenar conceptos, establecer criterios comunes y distinguir las prácticas consolidadas de las tendencias pasajeras.
Nuestro capítulo, “Predictive Analytics Models and Machine Learning”, repasa los principales modelos para anticipar comportamientos y resultados a partir de datos: desde los enfoques estadísticos clásicos hasta las técnicas de machine learning. Explica también cómo elegir, entrenar y evaluar estos modelos. Queremos que sirva como guía práctica y rigurosa para quien tenga que pasar de los datos a una predicción en la que se pueda confiar.
Predictive Analytics Models and Machine Learning: del conocimiento al problema real
por Antonio González Suárez
El capítulo aborda los tres grandes tipos de problema predictivo: clasificación, regresión y predicción de series temporales. Este último ocupa un lugar destacado por su relevancia en la industria. Anticipar la demanda, el consumo o la actividad de las próximas semanas es un requisito habitual en planificación y exige un tratamiento específico, ya que el orden temporal de los datos condiciona todo el proceso.
En la práctica, elegir un modelo implica decisiones que la teoría no resuelve por sí sola. Una de ellas es optar entre modelos estadísticos clásicos, como ARIMA o Prophet, o modelos de machine learning, como XGBoost o LightGBM. Otra es entrenar un modelo para cada horizonte de predicción o un único modelo aplicado de forma recursiva; esta segunda opción simplifica el mantenimiento, pero acumula error a medida que se amplía el horizonte. El capítulo compara estas alternativas y sus implicaciones, ya que no existe una solución universal.
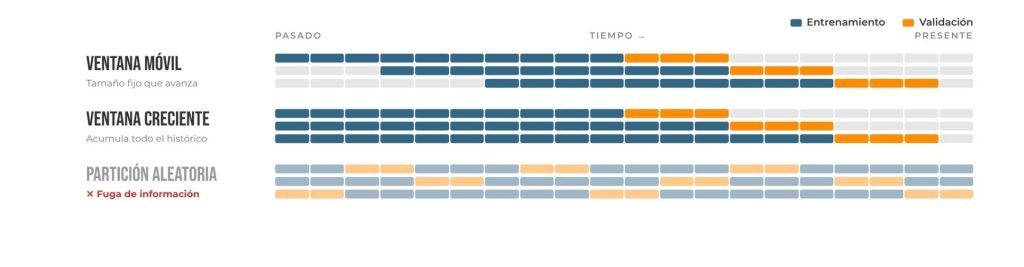
El segundo reto es verificar el rendimiento real del modelo. En series temporales, una validación que no respeta el orden de los datos introduce información del futuro en el entrenamiento y ofrece resultados más optimistas que los que se obtendrán en producción. El capítulo dedica un apartado a la validación con ventanas móviles y crecientes, a la prevención de esta fuga de información y a la selección de métricas alineadas con los objetivos de negocio.
Por último, los datos deben transformarse para que el modelo pueda aprender de ellos: valores históricos, medias móviles, variables de calendario, festivos o factores externos. Esta fase suele tener más impacto en el resultado que la elección del algoritmo.
Es exactamente lo que hacemos en Baobab: partir del problema real, elegir el enfoque que encaja con los datos disponibles, validarlo con rigor y, después, convertir la predicción en decisiones de planificación con nuestros modelos de optimización.
Más allá de la publicación: conectar investigación y empresa
por Álvaro García Sánchez
En Baobab, la investigación forma parte del modelo de trabajo. Los problemas que plantean las empresas industriales (planificar, predecir, asignar recursos o decidir en contextos de incertidumbre) rara vez admiten soluciones estándar. Abordarlos exige conocer el estado del arte: qué métodos existen, cuáles son eficaces y en qué condiciones. Por ello seguimos de forma continua la literatura científica, como base para ofrecer en cada caso la solución más adecuada.
Pero no nos quedamos en consumir conocimiento: también lo generamos. En Baobab impulsamos iniciativas de investigación propias, financiadas con fondos propios y, en algunos casos, con apoyo parcial de fondos públicos. Entre ellas hay doctorados industriales, contratos Torres Quevedo y proyectos de investigación, unos en colaboración con otros socios y otros desarrollados íntegramente por nuestro equipo. Con estas líneas de trabajo tratamos de ir un paso más allá de lo que ya está resuelto y explorar enfoques que todavía no se aplican en la industria.
Los proyectos reales plantean datos incompletos, sistemas heredados, restricciones operativas y usuarios que necesitan confiar en los resultados. Esa experiencia da lugar a preguntas de investigación que difícilmente surgirían solo en el ámbito académico. A su vez, la investigación revierte en la plataforma en forma de modelos más robustos y criterios más precisos sobre cuándo aplicar cada técnica.
Las dos vías se alimentan mutuamente. Los proyectos con clientes nos ponen delante de datos incompletos, sistemas heredados, restricciones operativas y usuarios que tienen que confiar en lo que les proponemos. Esa experiencia nos lleva a preguntas de investigación que difícilmente surgirían solo en el ámbito académico. A su vez, lo que aprendemos investigando vuelve a los proyectos en forma de modelos más sólidos, métodos mejor fundamentados y mejores criterios para saber cuándo una técnica es la adecuada y cuándo no.
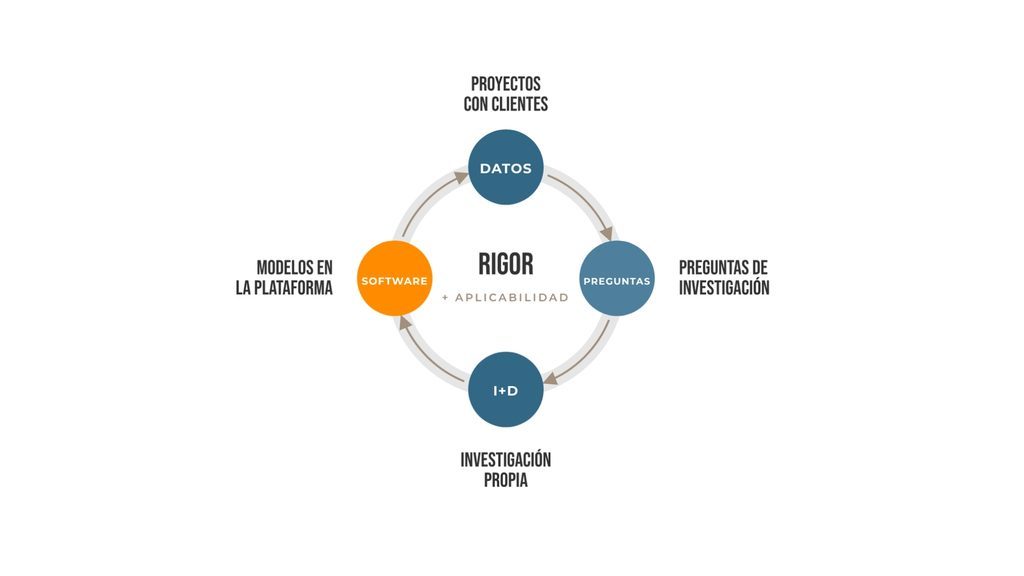
Esta doble perspectiva, académica y empresarial, nos permite mantener el rigor sin perder de vista la aplicabilidad. El conocimiento que genera nuestro equipo se traduce en soluciones para nuestros clientes y, al mismo tiempo, se devuelve a la comunidad científica en forma de publicaciones, colaboraciones y formación de nuevos investigadores.
Nuestra participación en el Springer Handbook of Data Engineering es un buen ejemplo de ese círculo. El capítulo recoge lo que hemos aprendido estudiando la literatura y aplicándola a problemas reales, y lo pone a disposición de otros profesionales e investigadores. Para nosotros, esa es la mejor forma de entender la relación entre empresa e investigación: una conversación continua en la que las dos partes salen ganando.