

Antes de tomar cualquier decisión sobre una planta de energía renovable, alguien tiene que confiar en un dato: cuánto sol hace, cuánto viento sopla o cuánto se está produciendo. Ese dato procede de sensores instalados en el propio emplazamiento, que registran de forma continua las condiciones del recurso y el comportamiento de la instalación.
El problema aparece cuando esas mediciones dejan de representar correctamente la realidad. Los sensores pueden registrar lecturas erróneas o anómalas debido a fallos técnicos, interferencias o determinadas condiciones meteorológicas. Cuando esos errores pasan desapercibidos y terminan formando parte del histórico, también condicionan los análisis y las decisiones que dependen de esa información.
En artículos anteriores hemos explicado cómo la inteligencia artificial permite anticipar averías y optimizar el mantenimiento en infraestructuras energéticas, tanto en instalaciones eólicas como hidráulicas. Existe, sin embargo, una condición previa para que este tipo de modelos pueda aportar resultados fiables: la información utilizada también debe tener suficiente calidad.
Qué pasa cuando un sensor registra datos incorrectos
Muchas decisiones sobre una instalación renovable se apoyan en información histórica. En energía eólica, por ejemplo, conocer con precisión variables como la velocidad, la dirección o la turbulencia del viento resulta relevante para analizar las condiciones de un emplazamiento y reducir la incertidumbre asociada a decisiones de inversión y operación.
Cuando aparecen anomalías en esas series temporales, el problema no termina en una lectura incorrecta. Esa información puede utilizarse posteriormente en análisis energéticos o como entrada de otros modelos, por lo que la calidad del histórico condiciona también la calidad de los resultados posteriores.
Disponer de un gran volumen de datos no garantiza, por sí solo, que el análisis sea fiable. Lo importante es poder identificar qué mediciones reflejan correctamente el comportamiento observado y cuáles contienen anomalías que conviene detectar y corregir antes de utilizarlas.
Por qué detectar una anomalía no siempre es sencillo
Algunas lecturas erróneas pueden resultar evidentes, pero otras quedan integradas dentro de series temporales extensas y son más difíciles de identificar mediante una revisión convencional.
La dificultad aumenta porque una observación poco habitual no tiene por qué ser necesariamente incorrecta. En variables como el viento pueden producirse cambios importantes que forman parte del comportamiento real del recurso. El análisis, por tanto, no puede reducirse únicamente a localizar valores máximos, mínimos o registros que se alejan de un umbral determinado.
El reto consiste en analizar el comportamiento de la serie e identificar aquellos patrones que resultan anómalos dentro del conjunto de información disponible. Cuando el volumen de datos o el número de localizaciones aumenta, realizar este trabajo exclusivamente mediante revisión manual exige cada vez más tiempo y recursos técnicos.
Aquí es donde los modelos de Machine Learning permiten automatizar una parte del análisis.
Cómo ayuda el Machine Learning a detectar anomalías en datos de viento
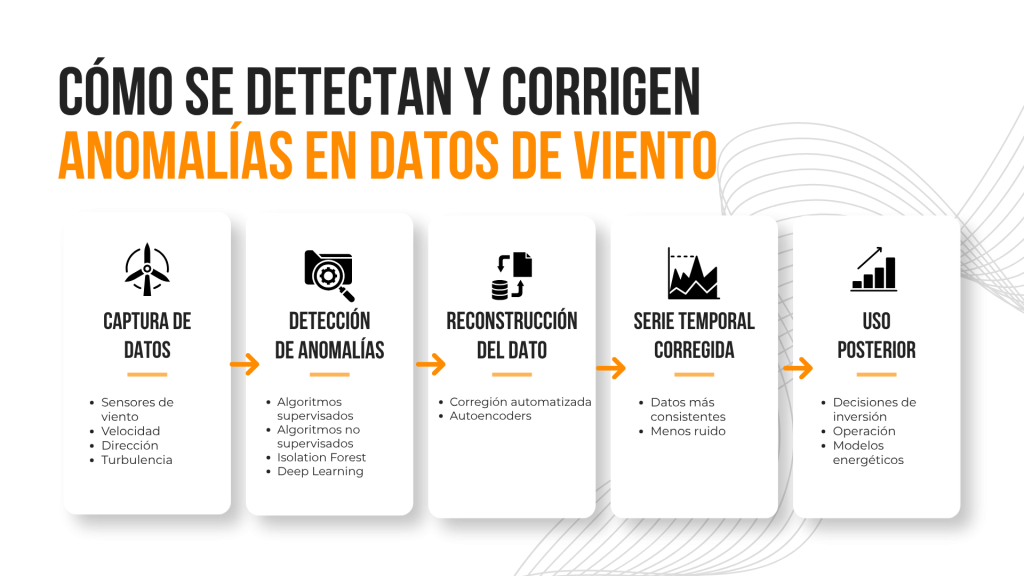
En uno de los proyectos desarrollados por Baobab AI para datos de viento se planteó una solución basada en inteligencia artificial y técnicas de aprendizaje automático para detectar automáticamente anomalías en series temporales. El enfoque combina algoritmos supervisados y no supervisados, entre ellos técnicas como Isolation Forest y modelos de Deep Learning.
Los modelos supervisados pueden aprender a reconocer determinados comportamientos cuando existen ejemplos previamente clasificados. Los algoritmos no supervisados permiten abordar una situación diferente: identificar observaciones que se alejan del comportamiento habitual sin necesitar que todos los posibles tipos de anomalía hayan sido etiquetados con anterioridad.
Esta combinación resulta especialmente útil cuando se trabaja con series en las que pueden aparecer distintos tipos de comportamientos anómalos. En lugar de depender únicamente de una revisión manual o de reglas rígidas, el modelo analiza patrones dentro de los datos y ayuda a localizar registros que requieren ser tratados.
La utilidad de este enfoque está directamente relacionada con la decisión posterior. Detectar una anomalía permite evitar que información incorrecta continúe utilizándose como si representara el comportamiento real del recurso.
Detectar el dato anómalo no resuelve todo el problema
Una vez identificada una observación anómala aparece una segunda necesidad: corregirla sin perder la integridad de la serie temporal.
Eliminar todos los valores sospechosos puede generar huecos en el histórico que dificulten los análisis posteriores. Por esta razón, el proyecto desarrollado por Baobab AI contempla también la corrección automatizada de los valores anómalos detectados.
Entre las técnicas empleadas se encuentran los autoencoders, redes neuronales que aprenden a comprimir y reconstruir los datos. Cuando una observación presenta un comportamiento diferente de los patrones aprendidos por el modelo, la reconstrucción puede mostrar un error mayor, lo que ayuda a señalar una posible anomalía.
Este mecanismo permite utilizar la reconstrucción como parte del propio proceso de análisis. El objetivo es conservar la integridad de la serie y mejorar la calidad de la información que utilizarán posteriormente otros análisis o modelos energéticos.
La reconstrucción no debe entenderse como un simple relleno de valores ausentes. Forma parte de un proceso orientado a detectar y corregir información anómala para disponer de una base de datos más adecuada para las decisiones que vienen después.
Cómo extender el análisis a diferentes localizaciones
Cuando una organización trabaja con múltiples emplazamientos, la capacidad de reutilizar un modelo se convierte en una cuestión relevante. Si cada nueva ubicación obliga a iniciar el proceso desde cero, el esfuerzo necesario para extender la solución aumenta considerablemente.
El caso desarrollado por Baobab AI incorpora precisamente un componente de generalización geográfica. Los modelos entrenados pueden exportarse y reutilizarse directamente en otras ubicaciones sin necesidad de recalibración, lo que permite aplicar el enfoque en múltiples localizaciones con una intervención reducida.
Esta capacidad facilita la extensión del análisis cuando una compañía necesita trabajar con datos procedentes de distintos emplazamientos. La escalabilidad no depende únicamente de procesar más registros, sino también de poder reutilizar el conocimiento desarrollado sin reconstruir completamente la solución para cada nueva ubicación.
¿Quieres profundizar en cómo se generan datos sintéticos y qué valor pueden aportar en proyectos de analítica e IA?
Descubre en nuestro blog cómo funciona la generación de datos sintéticos, sus principales aplicaciones y por qué puede ser clave cuando los datos reales son escasos, sensibles o difíciles de obtener.
Qué aporta la detección y corrección automática de anomalías
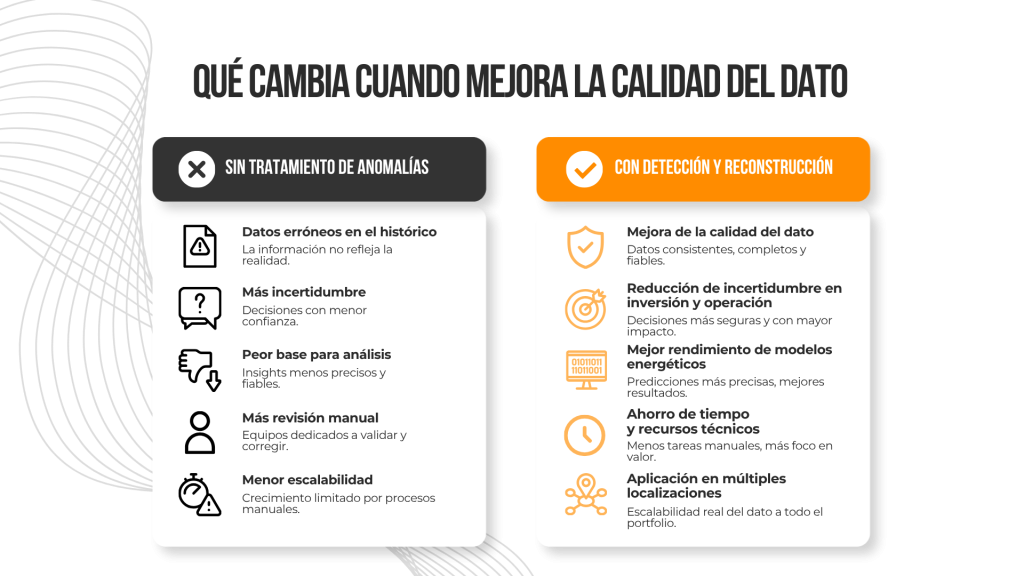
La detección y corrección automática de anomalías mejora la calidad de la información utilizada en los análisis energéticos y reduce la incertidumbre asociada a decisiones de inversión y operación.
También permite trabajar con series temporales más fiables, mejorar el rendimiento de los modelos energéticos y reducir el tiempo y los recursos técnicos dedicados a la revisión manual de los datos. Además, la reutilización de los modelos en distintas localizaciones facilita su aplicación en varios emplazamientos.
En Baobab AI aplicamos técnicas de Machine Learning y analítica avanzada para mejorar la calidad de los datos utilizados en decisiones de inversión, dimensionamiento y operación en el sector energético.


