
Cómo la inferencia bayesiana permite decidir con métricas ajustadas por riesgo.
Vamos a partir de un ejemplo simplificado que nos permita aislar un problema habitual en la toma de decisiones empresariales.
Imaginemos un comité de compras que debe adjudicar un contrato logístico semestral para 15.000 expediciones, con un SLA mínimo del 97% de entregas puntuales y penalizaciones por incumplimiento. En la fase final del proceso compiten dos operadores.
El Proveedor A ha realizado un piloto de ocho semanas en una región concreta, gestionando 120 envíos reales con un 99,8% de puntualidad y un coste un 6% inferior al de su competidor.
El Proveedor B, por su parte, acredita un 98,1% de puntualidad sobre 8.500 envíos comparables en el último año, incluyendo periodos de alta demanda, con baja variabilidad en tiempos de entrega y capacidad demostrada a gran escala.
A primera vista, el 99,8% parece superior al 98,1%. Sin embargo, el verdadero interrogante no está en el porcentaje, sino en la solidez estadística que lo respalda.
Los 120 envíos del piloto ofrecen una señal muy positiva, pero con mayor incertidumbre sobre su comportamiento futuro al escalar volumen y complejidad. En cambio, los 8.500 envíos históricos reducen significativamente esa incertidumbre y permiten estimar con mayor precisión el rango probable de desempeño.
No se trata de desconfiar de un buen resultado, sino de comprender que el tamaño muestral condiciona el nivel de riesgo que asumimos al decidir. La estadística no elimina la incertidumbre, pero permite cuantificarla. Y cuando pequeñas diferencias porcentuales pueden traducirse en impacto financiero y reputacional relevante, esa cuantificación deja de ser académica para convertirse en estratégica.
Cuando el volumen de datos crece y las comparativas se vuelven más complejas, la intuición deja de ser suficiente y la respuesta ya no es evidente. Es en ese punto donde necesitamos herramientas formales para distinguir señal de ruido.
La respuesta matemática: inferencia bayesiana
Para mitigar este riesgo con rigor, es necesario ir más allá de la estadística básica y aplicar la Inferencia bayesiana. En este enfoque, el rendimiento (por ejemplo, la tasa de puntualidad p) no se trata como un valor fijo, sino que se modela como una variable aleatoria.
Para procesos binarios de éxito o fracaso, como el cumplimiento de entregas en plazo, utilizamos típicamente una distribución beta. El proceso iterativo se fundamenta en dos conceptos clave:
- Priori: Es el punto de partida. Representa nuestra “creencia inicial” antes de ver ningún dato nuevo. Puede reflejar una incertidumbre amplia o incorporar conocimiento del mercado logístico (por ejemplo, “sabemos que el promedio sectorial en distribución nacional de OTD”).
- Posteriori: Es la actualización de esa creencia tras observar los datos reales del proveedor. La matemática bayesiana combina el priori con la evidencia observada para generar una nueva distribución de probabilidad ajustada.
En términos prácticos, el priori representa lo que sabemos antes de medir; el posteriori, lo que sabemos después de incorporar evidencia.
En el caso del Proveedor A (119 éxitos de 120), la distribución resultante sigue siendo relativamente ancha. Aunque su media es muy alta, la varianza refleja que el rendimiento real podría descender al escalar volumen, regiones y complejidad operativa.
En el caso del Proveedor B (aproximadamente 8.339 éxitos de 8.500), la distribución se concentra en un pico mucho más estrecho alrededor del 98%, ofreciendo una varianza mínima y una mayor seguridad sobre el dato.
La estrategia ganadora consiste en ordenar las opciones no por su media (E[p]), sino por el límite inferior de su intervalo de credibilidad (por ejemplo, al 95%). Matemáticamente, buscamos el valor x tal que P(p > x) = 0.95. Es decir, garantizamos con un 95% de probabilidad que el rendimiento real sea al menos ese valor. De esta forma, el modelo penaliza automáticamente la menor información disponible del Proveedor A, ajustando su puntuación por dispersión, mientras reconoce la solidez estadística del Proveedor B. El resultado es un ranking ajustado por riesgo, no solo por promedio.
De la teoría a la realidad operativa
La literatura científica sobre inferencia bayesiana es amplia, pero la realidad empresarial introduce matices adicionales. En logística, por ejemplo, el rendimiento puede no ser estacionario: campañas estacionales, cambios en rutas o variaciones en la demanda pueden alterar el comportamiento subyacente. También es frecuente la necesidad de prioris jerárquicos que integren información por región, tipo de producto o canal de distribución.
Debido a esta complejidad, es improbable que una herramienta estándar resuelva automáticamente la casuística específica de cada compañía. El modelo que sirve para evaluar transportistas no es directamente trasladable a la detección de fraude o al análisis de ensayos clínicos sin una adaptación profunda.
Para abordar esta brecha desde el rigor matemático, los modelos tendrán que estar ajustados a cada contexto:
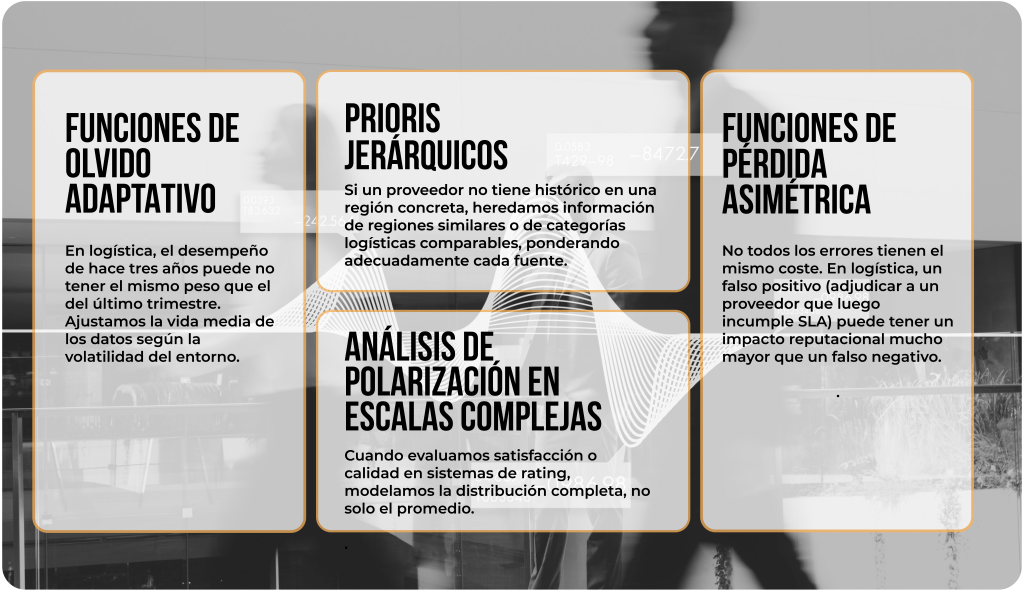
- Funciones de olvido adaptativas: En logística, el desempeño de hace tres años puede no tener el mismo peso que el del último trimestre. Ajustamos la vida media de los datos según la volatilidad del entorno.
- Prioris jerárquicos: Si un proveedor no tiene histórico en una región concreta, heredamos información de regiones similares o de categorías logísticas comparables, ponderando adecuadamente cada fuente.
- Análisis de polarización en escalas complejas: Cuando evaluamos satisfacción o calidad en sistemas de rating, modelamos la distribución completa, no solo el promedio.
- Funciones de pérdida asimétrica: No todos los errores tienen el mismo coste. En logística, un falso positivo (adjudicar a un proveedor que luego incumple SLA) puede tener un impacto reputacional mucho mayor que un falso negativo.
Impacto en la Industria
Este enfoque transforma la toma de decisiones al desplazar el foco desde el resultado puntual hacia la solidez estadística que lo respalda.
- En logística, por ejemplo, no se trata solo de comparar tasas de puntualidad, sino de estimar la probabilidad real de mantener ese rendimiento cuando aumenta el volumen, la complejidad de rutas o la presión estacional. Esto permite seleccionar operadores no por su mejor cifra puntual, sino por su fiabilidad estructural y su resiliencia operativa.
- En el sector energético, integrar explícitamente la incertidumbre meteorológica en los modelos de previsión mejora la gestión del riesgo en trading y en la planificación de oferta. No es lo mismo una predicción de generación renovable con baja varianza que otra con alta dispersión: el ajuste probabilístico permite optimizar coberturas y reducir exposición a escenarios extremos.
- En banca, este marco ayuda a diferenciar entre patrones de fraude consolidados y comportamientos atípicos pero naturales en cuentas de reciente creación. Al modelar la incertidumbre asociada al historial limitado, se reducen falsos positivos que impactan en la experiencia del cliente sin relajar la protección frente a riesgos reales.
- En marketing, evita la sobreasignación de presupuesto a segmentos que muestran tasas de conversión del 100% basadas en pocos casos. Incorporar el tamaño muestral y la varianza permite priorizar oportunidades con mayor probabilidad de escalar de forma sostenible, mejorando el retorno ajustado por riesgo.
- Finalmente, en I+D farmacéutica, este enfoque actúa como un filtro en fases tempranas: un compuesto con resultados preliminares prometedores pero basados en muestras pequeñas puede requerir evidencia adicional antes de avanzar a fases costosas. Así, la estadística no frena la innovación, sino que racionaliza la inversión al equilibrar potencial y certeza.
En todos estos sectores, el denominador común es el mismo: convertir la incertidumbre en una variable cuantificable permite tomar decisiones más consistentes, comparables y alineadas con la tolerancia al riesgo de cada organización.
La abundancia de datos no garantiza claridad estratégica. Los KPIs basados únicamente en estimaciones puntuales pueden ocultar el riesgo asociado al tamaño muestral y a la varianza. El verdadero salto cualitativo no consiste en disponer de más información, sino en incorporar explícitamente la incertidumbre en el propio modelo de decisión.
Diseñar este tipo de modelos exige adaptar la matemática al contexto operativo concreto: escala, calidad de datos, volatilidad del entorno y coste diferencial de cada tipo de error. No existen fórmulas universales aplicables sin ajuste. La ventaja competitiva surge cuando la modelización refleja la realidad del negocio y no solo una abstracción estadística.


